// todo
分类: leetcode
LCP61.气温变化趋势
目标
力扣城计划在两地设立「力扣嘉年华」的分会场,气象小组正在分析两地区的气温变化趋势,对于第 i ~ (i+1) 天的气温变化趋势,将根据以下规则判断:
- 若第 i+1 天的气温 高于 第 i 天,为 上升 趋势
- 若第 i+1 天的气温 等于 第 i 天,为 平稳 趋势
- 若第 i+1 天的气温 低于 第 i 天,为 下降 趋势
已知 temperatureA[i] 和 temperatureB[i] 分别表示第 i 天两地区的气温。 组委会希望找到一段天数尽可能多,且两地气温变化趋势相同的时间举办嘉年华活动。请分析并返回两地气温变化趋势相同的最大连续天数。
即最大的 n,使得第 i~i+n 天之间,两地气温变化趋势相同
示例 1:
输入: temperatureA = [21,18,18,18,31] temperatureB = [34,32,16,16,17]
输出:2
解释:如下表所示, 第 2~4 天两地气温变化趋势相同,且持续时间最长,因此返回 4 - 2 = 2| 天数 | 0~1 | 1~2 | 2~3 | 3~4 |
|---|---|---|---|---|
| 变化趋势A | 下降 | 平稳 | 平稳 | 上升 |
| 变化趋势B | 下降 | 下降 | 平稳 | 上升 |
示例 2:
输入: temperatureA = [5,10,16,-6,15,11,3] temperatureB = [16,22,23,23,25,3,-16]
输出:3
说明:
- 2 <= temperatureA.length == temperatureB.length <= 1000
- -20 <= temperatureA[i], temperatureB[i] <= 40
思路
简单的计数,容易出错的点是忘记比较最后的cnt。
知识点:
- 如何比较变化是否相同,使用API
Integer.compare或者 计算(x > y) - (x < y), boolean 值可以隐式转换成 0 或者 1。最直接的就是判断(a>b && c>d) || (a==b && c==d) || (a<b && c<d)
代码
/**
 * @date 2024-06-21 0:35
 */
public class TemperatureTrendLCP61 {

    public int temperatureTrend_v1(int[] temperatureA, int[] temperatureB) {
        int n = temperatureA.length;
        int res = 0;
        int cnt = 0;
        for (int i = 1; i < n; i++) {
            if (Integer.compare(temperatureA[i], temperatureA[i - 1]) == Integer.compare(temperatureB[i], temperatureB[i - 1])) {
                cnt++;
            } else {
                res = Math.max(res, cnt);
                cnt = 0;
            }
        }
        return Math.max(res, cnt);
    }

}
性能
2748.美丽下标对的数目
目标
给你一个下标从 0 开始的整数数组 nums 。如果下标对 i、j 满足 0 ≤ i < j < nums.length ,如果 nums[i] 的 第一个数字 和 nums[j] 的 最后一个数字 互质 ,则认为 nums[i] 和 nums[j] 是一组 美丽下标对 。
返回 nums 中 美丽下标对 的总数目。
对于两个整数 x 和 y ,如果不存在大于 1 的整数可以整除它们,则认为 x 和 y 互质 。换而言之,如果 gcd(x, y) == 1 ,则认为 x 和 y 互质,其中 gcd(x, y) 是 x 和 y 的 最大公因数 。
示例 1:
输入:nums = [2,5,1,4]
输出:5
解释:nums 中共有 5 组美丽下标对:
i = 0 和 j = 1 :nums[0] 的第一个数字是 2 ,nums[1] 的最后一个数字是 5 。2 和 5 互质,因此 gcd(2,5) == 1 。
i = 0 和 j = 2 :nums[0] 的第一个数字是 2 ,nums[2] 的最后一个数字是 1 。2 和 5 互质,因此 gcd(2,1) == 1 。
i = 1 和 j = 2 :nums[1] 的第一个数字是 5 ,nums[2] 的最后一个数字是 1 。2 和 5 互质,因此 gcd(5,1) == 1 。
i = 1 和 j = 3 :nums[1] 的第一个数字是 5 ,nums[3] 的最后一个数字是 4 。2 和 5 互质,因此 gcd(5,4) == 1 。
i = 2 和 j = 3 :nums[2] 的第一个数字是 1 ,nums[3] 的最后一个数字是 4 。2 和 5 互质,因此 gcd(1,4) == 1 。
因此,返回 5 。
示例 2:
输入:nums = [11,21,12]
输出:2
解释:共有 2 组美丽下标对:
i = 0 和 j = 1 :nums[0] 的第一个数字是 1 ,nums[1] 的最后一个数字是 1 。gcd(1,1) == 1 。
i = 0 和 j = 2 :nums[0] 的第一个数字是 1 ,nums[2] 的最后一个数字是 2 。gcd(1,2) == 1 。
因此,返回 2 。
说明:
- 2 <= nums.length <= 100
- 1 <= nums[i] <= 9999
- nums[i] % 10 != 0
思路
有一个整数数组,从中任选两个元素,如果下标小的元素的第一个数字与下标大的元素的最后一个数字互质,则称这两个元素为美丽下标对。求数组中美丽下标对的总数。
知识点:
- 如何获取元素值的第一个数字,
while(num>=10){num /=10;} - 如何判断互质,欧几里得算法
代码
/**
 * @date 2024-06-20 8:37
 */
public class CountBeautifulPairs2748 {

    /**
     * 优化,将外层循环获取第一个数字,然后依次向后比较
     * 改为记录之前遍历过数字的第一个数(1~9)的出现次数
     * 循环的时候只需遍历1~9 9个数字,取其中出现次数不为0的与当前数的最后一个数判断是否互质
     * 累加出现次数即可
     */
    public int countBeautifulPairs_v1(int[] nums) {
        int res = 0;
        int[] firstDigitsCnt = new int[10];
        for (int num : nums) {
            for (int j = 1; j < 10; j++) {
                if (firstDigitsCnt[j] != 0 && gcd(j, num % 10) == 1) {
                    res += firstDigitsCnt[j];
                }
            }
            while (num >= 10) {
                num /= 10;
            }
            firstDigitsCnt[num]++;
        }
        return res;
    }

    public int gcd(int x, int y) {
        return y == 0 ? x : gcd(y, x % y);
    }

    public int countBeautifulPairs_v2(int[] nums) {
        int res = 0;
        int[] firstDigitsCnt = new int[10];
        int[][] prime = new int[][]{
                {},
                {1, 2, 3, 4, 5, 6, 7, 8, 9},
                {1, 3, 5, 7, 9},
                {1, 2, 4, 5, 7, 8},
                {1, 3, 5, 7, 9},
                {1, 2, 3, 4, 6, 7, 8, 9},
                {1, 5, 7},
                {1, 2, 3, 4, 5, 6, 8, 9},
                {1, 3, 5, 7, 9},
                {1, 2, 4, 5, 7, 8}
        };
        for (int num : nums) {
            for (int p : prime[num % 10]) {
                res += firstDigitsCnt[p];
            }
            while (num >= 10) {
                num /= 10;
            }
            firstDigitsCnt[num]++;
        }
        return res;
    }
}
性能
最快的算法是预处理1~9对应的互质数组
2713.矩阵中严格递增的单元格数
目标
给你一个下标从 1 开始、大小为 m x n 的整数矩阵 mat,你可以选择任一单元格作为 起始单元格 。
从起始单元格出发,你可以移动到 同一行或同一列 中的任何其他单元格,但前提是目标单元格的值 严格大于 当前单元格的值。
你可以多次重复这一过程,从一个单元格移动到另一个单元格,直到无法再进行任何移动。
请你找出从某个单元开始访问矩阵所能访问的 单元格的最大数量 。
返回一个表示可访问单元格最大数量的整数。
示例 1:
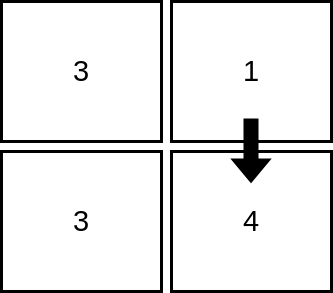
输入:mat = [[3,1],[3,4]]
输出:2
解释:上图展示了从第 1 行、第 2 列的单元格开始,可以访问 2 个单元格。可以证明,无论从哪个单元格开始,最多只能访问 2 个单元格,因此答案是 2 。
示例 2:
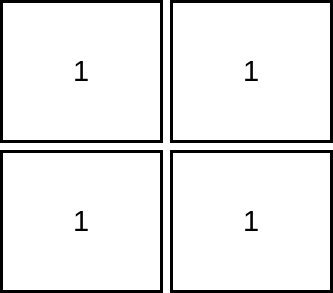
输入:mat = [[1,1],[1,1]]
输出:1
解释:由于目标单元格必须严格大于当前单元格,在本示例中只能访问 1 个单元格。
示例 3:
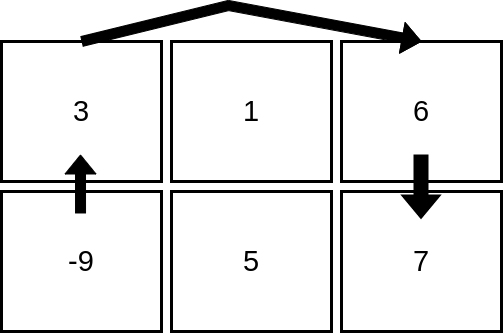
输入:mat = [[3,1,6],[-9,5,7]]
输出:4
解释:上图展示了从第 2 行、第 1 列的单元格开始,可以访问 4 个单元格。可以证明,无论从哪个单元格开始,最多只能访问 4 个单元格,因此答案是 4 。
说明:
- m == mat.length
- n == mat[i].length
- 1 <= m, n <= 10^5
- 1 <= m * n <= 10^5
-10^5 <= mat[i][j] <= 10^5
思路
有一个二维矩阵,我们可以从任意元素出发到达同行或同列的任意严格大于该元素值的位置,问我们最多能访问到多少单元格。
最直接的想法就是建立一个有向无环图,然后求最大路径长度。但是建图的过程需要循环mn(m+n)次,针对每个元素判断其同行同列上严格大于的元素。显然会超时。
于是考虑使用记忆化搜索,结果测试用例 558/566 超时,这个二维数组只有一行,有 100000列,从 1~100000,我在本地测试的时候报栈溢出。
我想要将其转为迭代的形式,但是时间紧迫,简单起见对一行或一列的情况做了特殊处理,排序后去重,最后勉强通过了。
官网题解使用的是动态规划,有时间详细看一下。//todo
代码
/**
 * @date 2024-06-19 16:28
 */
public class MaxIncreasingCells2713 {

    public int maxIncreasingCells(int[][] mat) {
        int res = 0;
        int m = mat.length;
        int n = mat[0].length;
        if (m == 1) {
            res = n;
            Arrays.sort(mat[0]);
            for (int i = 1; i < n; i++) {
                if (mat[0][i] == mat[0][i - 1]) {
                    res--;
                }
            }
            return res;
        } else if (n == 1) {
            res = m;
            Arrays.sort(mat, (a, b) -> a[0] - b[0]);
            for (int i = 1; i < m; i++) {
                if (mat[i][0] == mat[i - 1][0]) {
                    res--;
                }
            }
            return res;
        }

        int l = m * n;
        // 将二维坐标映射到一维,dp记录的是从该点为起点的能移动的最大次数
        int[] dp = new int[l];
        Arrays.fill(dp, -1);
        for (int i = 0; i < m; i++) {
            for (int j = 0; j < n; j++) {
                res = Math.max(res, move(mat, mat[i][j], i * n + j, i, j, dp));
            }
        }
        return res;
    }

    public int move(int[][] mat, int curVal, int next, int i, int j, int[] dp) {
        int m = mat.length;
        int n = mat[0].length;
        if (dp[next] > -1) {
            return dp[next];
        } else if (dp[next] == -2) {
            return 1;
        }
        boolean noNext = true;
        for (int k = 0; k < n; k++) {
            if (mat[i][k] > curVal) {
                noNext = false;
                dp[next] = Math.max(dp[next], move(mat, mat[i][k], i * n + k, i, k, dp) + 1);
            }
        }
        for (int k = 0; k < m; k++) {
            if (mat[k][j] > curVal) {
                noNext = false;
                dp[next] = Math.max(dp[next], move(mat, mat[k][j], k * n + j, k, j, dp) + 1);
            }
        }
        if (noNext) {
            dp[next] = -2;
            return 1;
        }

        return dp[next];
    }

}
性能

2288.价格减免
目标
句子 是由若干个单词组成的字符串,单词之间用单个空格分隔,其中每个单词可以包含数字、小写字母、和美元符号 '$' 。如果单词的形式为美元符号后跟着一个非负数值(A word represents a price if it is a sequence of digits preceded by a dollar sign.),那么这个单词就表示一个 价格 。
- 例如 "$100"、"$23" 和 "$6" 表示价格,而 "100"、"$" 和 "$1e5 不是。
给你一个字符串 sentence 表示一个句子和一个整数 discount 。对于每个表示价格的单词,都在价格的基础上减免 discount% ,并 更新 该单词到句子中。所有更新后的价格应该表示为一个 恰好保留小数点后两位 的数字。
返回表示修改后句子的字符串。
注意:所有价格 最多 为 10 位数字。
示例 1:
输入:sentence = "there are $1 $2 and 5$ candies in the shop", discount = 50
输出:"there are $0.50 $1.00 and 5$ candies in the shop"
解释:
表示价格的单词是 "$1" 和 "$2" 。
- "$1" 减免 50% 为 "$0.50" ,所以 "$1" 替换为 "$0.50" 。
- "$2" 减免 50% 为 "$1" ,所以 "$1" 替换为 "$1.00" 。
示例 2:
输入:sentence = "1 2 $3 4 $5 $6 7 8$ $9 $10$", discount = 100
输出:"1 2 $0.00 4 $0.00 $0.00 7 8$ $0.00 $10$"
解释:
任何价格减免 100% 都会得到 0 。
表示价格的单词分别是 "$3"、"$5"、"$6" 和 "$9"。
每个单词都替换为 "$0.00"。
说明:
- 1 <= sentence.length <= 105
- sentence 由小写英文字母、数字、' ' 和 '$' 组成
- sentence 不含前导和尾随空格
- sentence 的所有单词都用单个空格分隔
- 所有价格都是 正 整数且不含前导零
- 所有价格 最多 为 10 位数字
- 0 <= discount <= 100
思路
在许多脚本与命令中经常会使用 $+数字 形式的占位符来替换传入的参数。这个题就是要我们提取这个数字并进行一些操作然后再将处理后的数字替换回去。
知识点:
- 如何保留两位小数,可以使用
String.format("%.2f", 浮点数);类似C语言的字符串格式化。DecimalFormat df = new DecimalFormat("0.00"); df.format(浮点数); - 如何判断是否为数字,
Character.isDigit该API处理了不同code point上的数字,这里我们只需处理ISO-LATIN-1字符集的数字即可。直接比较c >= '0' c <='9'即可。 - 正则表达式断言,非捕获匹配以及捕获组的替换。匹配到的字符串被保存在
group(0),group(1~n)可以获取正则表达式中的捕获组。值得注意的是断言并不会出现在匹配的字符串中,而非捕获匹配不能通过group(1~n)访问,但还是会作为匹配字符被匹配到。appendReplacement会替换匹配到的字符串即group(0)。
需要注意防止数字的溢出,以及边界条件的处理。
官网是根据空格拆分为单词,然后再对单词进行处理,最后使用String.join将单词合并。
有网友使用JS直接用正则表达式匹配数字,并使用匿名函数计算折扣并替换。
leetcode 中Java不能用java.util.regex包,但是可以使用 splitWord.matches("(?<=(^|\\s)\\$)(\\d+)(?=\\s|$)") 判断是否是目标形式,也算是一种判断是否为数字的手段。当然我们也可以不判断数字,直接使用Long.parseLong解析并捕获异常,不处理异常即可。
代码
/**
 * @date 2024-06-18 0:39
 */
public class DiscountPrices2288 {

    /**
     * 遇到$就记录随后的数字,如果遇到非数字就将其append到buffer
     * 如果在遇到分隔符' '之前都是数字,那么计算折扣然后append到buffer
     * 里面需要特别主要在同一个单词内含有多个'$'导致多次开启记录数字
     * 只有开头以及前一个字符是' '的情况下才开启记录数字
     * 另外需要在循环外处理最后一个单词的数字,如果存在的话
     * 还要特别主要数字溢出
     */
    public String discountPrices(String sentence, int discount) {
        // BigDecimal不让用
//        BigDecimal mul = new BigDecimal((100 - discount) / 100.0);
        double mul = (100 - discount) / 100.0;
        DecimalFormat df = new DecimalFormat("0.00");
        int n = sentence.length();
        boolean skip = false;
        StringBuilder sb = new StringBuilder();
        StringBuilder num = new StringBuilder();
        for (int i = 0; i < n; i++) {
            char c = sentence.charAt(i);
            if (c != '$' || num.length() > 0) {
                if (!skip) {
                    sb.append(c);
                } else {
                    if (c >= '0' && c <= '9') {
                        num.append(c);
                    } else if (c == ' ' && num.length() > 0) {
                        // 这里应使用long
                        long origin = Long.parseLong(num.toString());
//                        BigDecimal discnt = new BigDecimal(origin).multiply(mul).setScale(2, BigDecimal.ROUND_HALF_UP);
                        double discnt = origin * mul;
                        sb.append(df.format(discnt)).append(c);
                        num = new StringBuilder();
                        skip = false;
                    } else {
                        sb.append(num).append(c);
                        num = new StringBuilder();
                        skip = false;
                    }
                }
            } else if (i == 0 || sentence.charAt(i - 1) == ' ') {
                // 这里不用else if(!skip),因为num.length >0 说明skip 为true
                skip = true;
                sb.append(c);
            } else {
                // 处理 $$$0 的情况
                if (skip) {
                    skip = false;
                }
                sb.append(c);
            }
        }
        // 处理结尾没有空格的情况
        if (num.length() > 0) {
            long origin = Long.parseLong(num.toString());
            double discnt = origin * mul;
            sb.append(df.format(discnt));
        }
        return sb.toString();
    }

}
性能
522.最长特殊序列ⅠⅠ
目标
给定字符串列表 strs ,返回其中 最长的特殊序列 的长度。如果最长特殊序列不存在,返回 -1 。
特殊序列 定义如下:该序列为某字符串 独有的子序列(即不能是其他字符串的子序列)。
s 的 子序列可以通过删去字符串 s 中的某些字符实现。
- 例如,"abc" 是 "aebdc" 的子序列,因为您可以删除"aebdc"中的下划线字符来得到 "abc" 。"aebdc"的子序列还包括"aebdc"、 "aeb" 和 "" (空字符串)。
示例 1:
输入: strs = ["aba","cdc","eae"]
输出: 3
示例 2:
输入: strs = ["aaa","aaa","aa"]
输出: -1
说明:
- 2 <= strs.length <= 50
- 1 <= strs[i].length <= 10
- strs[i] 只包含小写英文字母
思路
想要使用动态规划一定要先写弄清递推公式,否则思考的方向错了,编码会更加复杂。
这个题需要将每一个字符串与其它字符串比较,判断是否是其它字符串的子序列。
我们无法利用前面计算过的最长特殊序列来得出新的最长特殊序列,例如:
- "aabbcc", "aabbcc", "cb", "abc" 前两个字符串没有特殊子序列,前三个字符串最长特殊子序列为 "cb",而单看 "cb" 与 "abc" 的最长特殊序列是 "abc",但 "abc" 是前面两个字符串的子序列。
- "a", "b", "c", "d", "e", "f", "a", "b", "c", "d", "e", "f" 这组字符串如果不到最后一个,最长特殊子序列长度为1,如果整体来看子序列都不是唯一的。
//todo
代码
性能
521.最长特殊序列Ⅰ
目标
给你两个字符串 a 和 b,请返回 这两个字符串中 最长的特殊序列 的长度。如果不存在,则返回 -1 。
「最长特殊序列」 定义如下:该序列为 某字符串独有的最长子序列(即不能是其他字符串的子序列) 。
字符串 s 的子序列是在从 s 中删除任意数量的字符后可以获得的字符串。
- 例如,"abc" 是 "aebdc" 的子序列,因为删除 "aebdc" 中斜体加粗的字符可以得到 "abc" 。 "aebdc" 的子序列还包括 "aebdc" 、 "aeb" 和 "" (空字符串)。
示例 1:
输入: a = "aba", b = "cdc"
输出: 3
解释: 最长特殊序列可为 "aba" (或 "cdc"),两者均为自身的子序列且不是对方的子序列。
示例 2:
输入:a = "aaa", b = "bbb"
输出:3
解释: 最长特殊序列是 "aaa" 和 "bbb" 。
示例 3:
输入:a = "aaa", b = "aaa"
输出:-1
解释: 字符串 a 的每个子序列也是字符串 b 的每个子序列。同样,字符串 b 的每个子序列也是字符串 a 的子序列。
说明:
- 1 <= a.length, b.length <= 100
- a 和 b 由小写英文字母组成
思路
求两个字符串独有子序列的最大长度。很明显,如果二者长度不等则最大独有子序列就是最长字符串长度;如果二者长度相等,则需要看字符串是否相等,如果相等则表明没有独有子序列,返回-1,否则返回字符串长度。
代码
/**
 * @date 2024-06-16 0:07
 */
public class FindLUSlength521 {
    public int findLUSlength(String a, String b) {
        if (a.equals(b)) {
            return -1;
        } else {
            return Math.max(a.length(), b.length());
        }
    }
}
性能
202.快乐数
目标
编写一个算法来判断一个数 n 是不是快乐数。
「快乐数」 定义为:
- 对于一个正整数,每一次将该数替换为它每个位置上的数字的平方和。
- 然后重复这个过程直到这个数变为 1,也可能是 无限循环 但始终变不到 1。
- 如果这个过程 结果为 1,那么这个数就是快乐数。
如果 n 是 快乐数 就返回 true ;不是,则返回 false 。
示例 1:
输入:n = 19
输出:true
解释:
12 + 92 = 82
82 + 22 = 68
62 + 82 = 100
12 + 02 + 02 = 1
示例 2:
输入:n = 2
输出:false
提示:
1 <= n <= 2^31 - 1
思路
难点是如何确定停止条件,我甚至想过记录循环次数如果超过某一个数就返回false。我意识到这可能是一个数学问题,就放弃了。
看了题解才明白,问题看似是开放的,但也是有规律的,关键是如何分析这个问题。
考虑最终可能出现的情况:
- 最终会得到 1。
- 最终会进入循环。
- 值会越来越大,最后接近无穷大。
考虑不同位数数字的最大值,进行一次计算的结果:
| 位数 | 最大值 | 下一个值 |
|---|---|---|
| 1 | 9 | 81 |
| 2 | 99 | 162 |
| 3 | 999 | 243 |
| 4 | 9999 | 324 |
| 13 | 9999999999999 | 81*13=1053 |
相应位上小于最大值的数字,其下一个值也必定小于最大值的下一个值。
意识到存在循环是很重要的,然后我们可以使用哈希表记录出现过的元素,也可以使用弗洛伊德循环检测算法(Floyd's Cycle-Finding Algorithm)又称为龟兔赛跑算法(Tortoise and Hare Algorithm),注意不是图论中求最短路径的弗洛伊德算法。
// todo 自己实现一下
代码
/**
 * @date 2024-06-15 20:59
 */
public class IsHappy202 {

    /**
     * 快慢指针,也是用来检测链表中是否存在环
     * 快慢如果相遇就说明存在环,否则快的先遇到1
     */
    class Solution_v1 {
        public int getNext(int n) {
            int totalSum = 0;
            while (n > 0) {
                int d = n % 10;
                n = n / 10;
                totalSum += d * d;
            }
            return totalSum;
        }

        public boolean isHappy(int n) {
            int slowRunner = n;
            int fastRunner = getNext(n);
            while (fastRunner != 1 && slowRunner != fastRunner) {
                slowRunner = getNext(slowRunner);
                fastRunner = getNext(getNext(fastRunner));
            }
            return fastRunner == 1;
        }
    }

    /**
     * Set记录每次的数字,如果重复就返回false
     */
    class Solution {
        private int getNext(int n) {
            int totalSum = 0;
            while (n > 0) {
                int d = n % 10;
                n = n / 10;
                totalSum += d * d;
            }
            return totalSum;
        }

        public boolean isHappy(int n) {
            Set<Integer> seen = new HashSet<>();
            while (n != 1 && !seen.contains(n)) {
                seen.add(n);
                n = getNext(n);
            }
            return n == 1;
        }
    }

    /**
     * 实际上只会存在一个循环4→16→37→58→89→145→42→20→4
     */
    private static Set<Integer> cycleMembers =
        new HashSet<>(Arrays.asList(4, 16, 37, 58, 89, 145, 42, 20));

    public int getNext(int n) {
        int totalSum = 0;
        while (n > 0) {
            int d = n % 10;
            n = n / 10;
            totalSum += d * d;
        }
        return totalSum;
    }

    public boolean isHappy(int n) {
        while (n != 1 && !cycleMembers.contains(n)) {
            n = getNext(n);
        }
        return n == 1;
    }

}
性能
略
2786.访问数组中的位置使分数最大
目标
给你一个下标从 0 开始的整数数组 nums 和一个正整数 x 。
你 一开始 在数组的位置 0 处,你可以按照下述规则访问数组中的其他位置:
- 如果你当前在位置 i ,那么你可以移动到满足 i < j 的 任意 位置 j 。
- 对于你访问的位置 i ,你可以获得分数 nums[i] 。
- 如果你从位置 i 移动到位置 j 且 nums[i] 和 nums[j] 的 奇偶性 不同,那么你将失去分数 x 。
请你返回你能得到的 最大 得分之和。
注意 ,你一开始的分数为 nums[0] 。
示例 1:
输入:nums = [2,3,6,1,9,2], x = 5
输出:13
解释:我们可以按顺序访问数组中的位置:0 -> 2 -> 3 -> 4 。
对应位置的值为 2 ,6 ,1 和 9 。因为 6 和 1 的奇偶性不同,所以下标从 2 -> 3 让你失去 x = 5 分。
总得分为:2 + 6 + 1 + 9 - 5 = 13 。
示例 2:
输入:nums = [2,4,6,8], x = 3
输出:20
解释:数组中的所有元素奇偶性都一样,所以我们可以将每个元素都访问一次,而且不会失去任何分数。
总得分为:2 + 4 + 6 + 8 = 20 。
说明:
- 2 <= nums.length <= 10^5
- 1 <= nums[i], x <= 10^6
思路
给定一个数组 nums 与 正整数 x,从下标 0 开始,允许从任意位置 i 开始向后访问位置 j,如果nums[i] 与 nums[j] 的奇偶性相同,则可以获得 nums[j] 分,否则获得 nums[j] - x 分。求能够获得的分数总和的最大值。
刚开始就想到要从后向前,自底向上动态规划,如果当前的奇偶性与与后面的奇偶性相同就累加,否则就将后面的值减去x。接着又想到并不是要每一个节点都要访问,如果节点没有访问奇偶性和谁比较呢?并且后面的得分取决于前一个元素的奇偶性,考虑到昨天的题 子序列最大优雅度,觉得可能方向又错了。
于是就尝试贪心算法,从下标0开始,执行while循环,如果后面的元素奇偶性与之相同,直接累加。对于奇偶性不同的,我们可以考虑累加或者跳过。这样问题就变成了从这个新位置开始向后能获取的最大分数。注意新的位置奇偶性发生了变化。
这么一想问题又变成记忆化搜索了,于是就可以转换为递推/动态规划问题。
// todo 转换为动态规划的写法
代码
/**
 * @date 2024-06-14 8:43
 */
public class MaxScore2786 {

    public long maxScore(int[] nums, int x) {
        int n = nums.length;
        long[][] mem = new long[n + 1][2];
        for (int i = 0; i < mem.length; i++) {
            mem[i] = new long[]{Integer.MIN_VALUE, Integer.MIN_VALUE};
        }
        long res = nums[0];
        int flag = nums[0] % 2;
        int i = 1;
        while (i < n && nums[i] % 2 == flag) {
            res += nums[i];
            i++;
        }
        res += Math.max(0, maxScore(nums, x, i, flag, mem));
        return res;
    }

    public long maxScore(int[] nums, int x, int start, int preFlag, long[][] mem) {
        int n = nums.length;
        if (start >= n) {
            return 0;
        }
        // 如果选择该节点
        int flag = nums[start] % 2;
        long select = nums[start];
        if (preFlag != flag) {
            select -= x;
        }
        int i = start + 1;
        while (i < n && nums[i] % 2 == flag) {
            select += nums[i];
            i++;
        }
        if (mem[i][flag] == Integer.MIN_VALUE) {
            mem[i][flag] = maxScore(nums, x, i, flag, mem);
        }
        select += Math.max(0, mem[i][flag]);
        // 如果跳过该节点
        if (mem[start + 1][preFlag] == Integer.MIN_VALUE) {
            mem[start + 1][preFlag] = maxScore(nums, x, start + 1, preFlag, mem);
        }
        return Math.max(select, mem[start + 1][preFlag]);
    }

}
性能
2813.子序列最大优雅度
目标
给你一个长度为 n 的二维整数数组 items 和一个整数 k 。
items[i] = [profiti, categoryi],其中 profiti 和 categoryi 分别表示第 i 个项目的利润和类别。
现定义 items 的 子序列 的 优雅度 可以用 total_profit + distinct_categories^2 计算,其中 total_profit 是子序列中所有项目的利润总和,distinct_categories 是所选子序列所含的所有类别中不同类别的数量。
你的任务是从 items 所有长度为 k 的子序列中,找出 最大优雅度 。
用整数形式表示并返回 items 中所有长度恰好为 k 的子序列的最大优雅度。
注意:数组的子序列是经由原数组删除一些元素(可能不删除)而产生的新数组,且删除不改变其余元素相对顺序。
示例 1:
输入:items = [[3,2],[5,1],[10,1]], k = 2
输出:17
解释:
在这个例子中,我们需要选出长度为 2 的子序列。
其中一种方案是 items[0] = [3,2] 和 items[2] = [10,1] 。
子序列的总利润为 3 + 10 = 13 ,子序列包含 2 种不同类别 [2,1] 。
因此,优雅度为 13 + 22 = 17 ,可以证明 17 是可以获得的最大优雅度。
示例 2:
输入:items = [[3,1],[3,1],[2,2],[5,3]], k = 3
输出:19
解释:
在这个例子中,我们需要选出长度为 3 的子序列。
其中一种方案是 items[0] = [3,1] ,items[2] = [2,2] 和 items[3] = [5,3] 。
子序列的总利润为 3 + 2 + 5 = 10 ,子序列包含 3 种不同类别 [1, 2, 3] 。
因此,优雅度为 10 + 32 = 19 ,可以证明 19 是可以获得的最大优雅度。
示例 3:
输入:items = [[1,1],[2,1],[3,1]], k = 3
输出:7
解释:
在这个例子中,我们需要选出长度为 3 的子序列。
我们需要选中所有项目。
子序列的总利润为 1 + 2 + 3 = 6,子序列包含 1 种不同类别 [1] 。
因此,最大优雅度为 6 + 12 = 7 。
说明:
- 1 <= items.length == n <= 10^5
- items[i].length == 2
items[i][0] == profitiitems[i][1] == categoryi- 1 <= profiti <= 10^9
- 1 <= categoryi <= n
- 1 <= k <= n
思路
已知一个二维数组,元素为[利润, 种类],数组子序列的优雅值定义为利润和 + 不同种类数量^2,让我们求子序列最大的优雅值是多少。
这道题没有做出来,思考方向错了。刚开始想的是使用记忆化搜索,但是后来发现问题的解不一定能够从子问题得出。即 k-1 子序列的优雅值不一定能够得到 k 子序列的优雅值。
例如:{10, 5} -> {10, 2}, {6, 1}, {9, 5},k = 3,我们先固定第一项,然后从后面取 k 为 2 的优雅值最大子序列 {10, 2}, {9, 5}。但是与第一项结合之后,发现类别有重复的,优雅值为 29 + 4 = 33,小于取 {10, 2}, {6, 1} 得到的优雅值 26 + 9 = 35。
因此使用递归或者动态规划都是不可解的,不能转换成规模更小的子问题。 //2024.06.14 也有可能是可以解的,只不过没有找到正确的切入点。参考访问数组中的位置使分数最大
官网题解使用的是贪心算法,由于后面会对之前的贪心选择做出调整,有网友称为反悔贪心算法。
由于我们求的是优雅值,相对顺序没有影响,因此可以排序。
然后先取最大的k个值,如果其中类别有重复的,尝试用后面的不同类别替换类别重复但利润较小的,直到没有重复的即可。
这是357场周赛的最后一题,2500多分。
代码
//todo