3882.网格图中最小异或路径

目标

给你一个大小为 m * n 的二维整数数组 grid。

你从 左上角 的单元格 (0, 0) 出发,想要到达 右下角 的单元格 (m - 1, n - 1)。

在每一步中,你 可以 向右或向下 移动。

路径的 代价 定义为该路径上所有单元格(包括 起点和终点)的值的 按位异或。

返回从 (0, 0) 到 (m - 1, n - 1) 的所有有效路径中 最小 的可能异或值。

示例 1:

输入: grid = [[1,2],[3,4]]
输出: 6
解释:
有两条有效路径:
(0, 0) → (0, 1) → (1, 1),异或值为:1 XOR 2 XOR 4 = 7
(0, 0) → (1, 0) → (1, 1),异或值为:1 XOR 3 XOR 4 = 6
所有有效路径中的最小异或值为 6。

示例 2:

输入: grid = [[6,7],[5,8]]
输出: 9
解释:
有两条有效路径:
(0, 0) → (0, 1) → (1, 1),异或值为:6 XOR 7 XOR 8 = 9
(0, 0) → (1, 0) → (1, 1),异或值为:6 XOR 5 XOR 8 = 11
所有有效路径中的最小异或值为 9。

示例 3:

输入: grid = [[2,7,5]]
输出: 0
解释:
只有一条有效路径:
(0, 0) → (0, 1) → (0, 2),异或值为:2 XOR 7 XOR 5 = 0
这条路径的异或值为 0,这是可能达到的最小值。

说明:

  • 1 <= m == grid.length <= 1000
  • 1 <= n == grid[i].length <= 1000
  • m * n <= 1000
  • 0 <= grid[i][j] <= 1023​

思路

有一个 m x n 的网格,允许向下或向右移动,求从左上到右下的路径上元素异或和的最小值。

注意到 m * n <= 1000,可以记忆路径到达 (i,j) 时的异或和,如果该状态已经访问过则跳过。

代码


/**
 * @date 2026-10-28 9:18
 */
public class MinCost3882 {

    public int minCost(int[][] grid) {
        int m = grid.length;
        int n = grid[0].length;
        boolean[][][] mem = new boolean[m][n][1024];
        dfs(0, 0, 0, grid, mem);
        for (int i = 0; i < 1024; i++) {
            if (mem[m - 1][n - 1][i]) {
                return i;
            }
        }
        return -1;
    }

    public void dfs(int i, int j, int xor, int[][] grid, boolean[][][] mem) {
        int m = grid.length;
        int n = grid[0].length;
        if (i >= m || j >= n) {
            return;
        }
        xor ^= grid[i][j];
        if (mem[i][j][xor]) {
            return;
        }
        mem[i][j][xor] = true;
        dfs(i + 1, j, xor, grid, mem);
        dfs(i, j + 1, xor, grid, mem);
    }

}

性能
3619.总价值可以被K整除的岛屿数目

目标

给你一个 m x n 的矩阵 grid 和一个正整数 k。一个 岛屿 是由 正 整数(表示陆地)组成的,并且陆地间 四周 连通(水平或垂直)。

一个岛屿的总价值是该岛屿中所有单元格的值之和。

返回总价值可以被 k 整除 的岛屿数量。

示例 1:

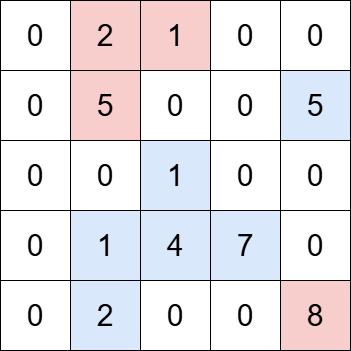
输入: grid = [[0,2,1,0,0],[0,5,0,0,5],[0,0,1,0,0],[0,1,4,7,0],[0,2,0,0,8]], k = 5
输出: 2
解释:
网格中包含四个岛屿。蓝色高亮显示的岛屿的总价值可以被 5 整除,而红色高亮显示的岛屿则不能。

示例 2:

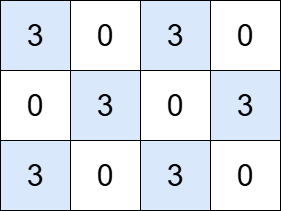
输入: grid = [[3,0,3,0], [0,3,0,3], [3,0,3,0]], k = 3
输出: 6
解释:
网格中包含六个岛屿,每个岛屿的总价值都可以被 3 整除。

说明:

  • m == grid.length
  • n == grid[i].length
  • 1 <= m, n <= 1000
  • 1 <= m * n <= 10^5
  • 0 <= grid[i][j] <= 10^6
  • 1 <= k < = 10^6

思路

有一个 m x n 矩阵 grid 和一个正整数 k,定义正整数的格子为陆地,陆地四周相连组成的区域称为岛屿,岛屿的总价值为所有单元格的值之和。求矩阵中总价值能被 k 整除的岛屿数量。

枚举所有格子,以它为起点 dfs 矩阵,返回总价值,跳过已访问过的格子。

代码


/**
 * @date 2026-10-26 9:44
 */
public class CountIslands3619 {

    int[][] directions = new int[][]{{-1, 0}, {0, 1}, {1, 0}, {0, -1}};

    public int countIslands(int[][] grid, int k) {
        int m = grid.length;
        int n = grid[0].length;
        int res = 0;
        boolean[][] visited = new boolean[m][n];
        for (int i = 0; i < m; i++) {
            for (int j = 0; j < n; j++) {
                if (grid[i][j] == 0) {
                    visited[i][j] = true;
                } else if (!visited[i][j] && dfs(i, j, grid, visited) % k == 0) {
                    res++;
                }
            }
        }
        return res;
    }

    public long dfs(int i, int j, int[][] grid, boolean[][] visited) {
        int m = grid.length;
        int n = grid[0].length;
        visited[i][j] = true;
        long res = grid[i][j];
        for (int[] d : directions) {
            int ni = i + d[0];
            int nj = j + d[1];
            if (ni >= 0 && nj >= 0 && ni < m && nj < n && grid[i][j] > 0 && !visited[ni][nj]) {
                res += dfs(ni, nj, grid, visited);
            }
        }
        return res;
    }
}

性能

1520.最多的不重叠子字符串

目标

给你一个只包含小写字母的字符串 s ,你需要找到 s 中最多数目的非空子字符串,满足如下条件:

  1. 这些字符串之间互不重叠,也就是说对于任意两个子字符串 s[i..j] 和 s[x..y] ,要么 j < x 要么 i > y 。
  2. 如果一个子字符串包含字符 char ,那么 s 中所有 char 字符都应该在这个子字符串中。

请你找到满足上述条件的最多子字符串数目。如果有多个解法有相同的子字符串数目,请返回这些子字符串总长度最小的一个解。可以证明最小总长度解是唯一的。

请注意,你可以以 任意 顺序返回最优解的子字符串。

示例 1:

输入:s = "adefaddaccc"
输出:["e","f","ccc"]
解释:下面为所有满足第二个条件的子字符串:
[
  "adefaddaccc"
  "adefadda",
  "ef",
  "e",
  "f",
  "ccc",
]
如果我们选择第一个字符串,那么我们无法再选择其他任何字符串,所以答案为 1 。如果我们选择 "adefadda" ,剩下子字符串中我们只可以选择 "ccc" ,它是唯一不重叠的子字符串,所以答案为 2 。同时我们可以发现,选择 "ef" 不是最优的,因为它可以被拆分成 2 个子字符串。所以最优解是选择 ["e","f","ccc"] ,答案为 3 。不存在别的相同数目子字符串解。

示例 2:

输入:s = "abbaccd"
输出:["d","bb","cc"]
解释:注意到解 ["d","abba","cc"] 答案也为 3 ,但它不是最优解,因为它的总长度更长。

说明:

  • 1 <= s.length <= 10^5
  • s 只包含小写英文字母。

思路

代码

性能

2265.统计值等于子树平均值的节点数

目标

给你一棵二叉树的根节点 root ,找出并返回满足要求的节点数,要求节点的值等于其 子树 中值的 平均值 。

注意:

  • n 个元素的平均值可以由 n 个元素 求和 然后再除以 n ,并 向下舍入 到最近的整数。
  • root 的 子树 由 root 和它的所有后代组成。

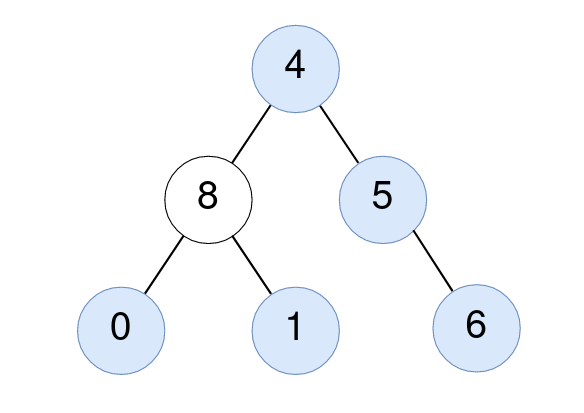
示例 1:

输入:root = [4,8,5,0,1,null,6]
输出:5
解释:
对值为 4 的节点:子树的平均值 (4 + 8 + 5 + 0 + 1 + 6) / 6 = 24 / 6 = 4 。
对值为 5 的节点:子树的平均值 (5 + 6) / 2 = 11 / 2 = 5 。
对值为 0 的节点:子树的平均值 0 / 1 = 0 。
对值为 1 的节点:子树的平均值 1 / 1 = 1 。
对值为 6 的节点:子树的平均值 6 / 1 = 6 。

示例 2:

输入:root = [1]
输出:1
解释:对值为 1 的节点:子树的平均值 1 / 1 = 1。

说明:

  • 树中节点数目在范围 [1, 1000] 内
  • 0 <= Node.val <= 1000

思路

有一颗二叉树,统计其中节点值等于子树平均值(节点本身及其子树的节点值之和除以节点个数向下取整)的节点个数。

dfs 依题意统计即可。

代码


/**
 * @date 2026-09-10 8:56
 */
public class AverageOfSubtree2265 {

    int res = 0;

    public int averageOfSubtree(TreeNode root) {
        dfs(root);
        return res;
    }

    public class Dto {
        public int sum;
        public int num;

        public Dto() {
        }

        public Dto(int sum, int num) {
            this.sum = sum;
            this.num = num;
        }
    }

    public Dto dfs(TreeNode node) {
        if (node == null) {
            return new Dto();
        }
        Dto cur = new Dto(node.val, 1);
        Dto l = dfs(node.left);
        Dto r = dfs(node.right);
        cur.sum += l.sum + r.sum;
        cur.num += l.num + r.num;
        if (node.val == cur.sum / cur.num) {
            res++;
        }
        return cur;
    }
}
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 * int val;
 * TreeNode left;
 * TreeNode right;
 * TreeNode() {}
 * TreeNode(int val) { this.val = val; }
 * TreeNode(int val, TreeNode left, TreeNode right) {
 * this.val = val;
 * this.left = left;
 * this.right = right;
 * }
 * }
 */

性能

3310.移除可疑的方法

目标

你正在维护一个项目,该项目有 n 个方法,编号从 0 到 n - 1。

给你两个整数 n 和 k,以及一个二维整数数组 invocations,其中 invocations[i] = [ai, bi] 表示方法 ai 调用了方法 bi。

已知如果方法 k 存在一个已知的 bug。那么方法 k 以及它直接或间接调用的任何方法都被视为 可疑方法 ,我们需要从项目中移除这些方法。

只有当一组方法没有被这组之外的任何方法调用时,这组方法才能被移除。

返回一个数组,包含移除所有 可疑方法 后剩下的所有方法。你可以以任意顺序返回答案。如果无法移除 所有 可疑方法,则 不 移除任何方法。

示例 1:

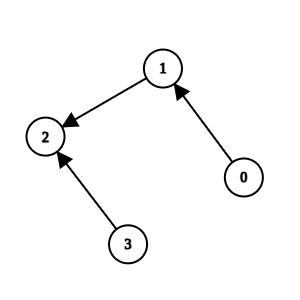
输入: n = 4, k = 1, invocations = [[1,2],[0,1],[3,2]]
输出: [0,1,2,3]
解释:
方法 2 和方法 1 是可疑方法,但它们分别直接被方法 3 和方法 0 调用。由于方法 3 和方法 0 不是可疑方法,我们无法移除任何方法,故返回所有方法。

示例 2:

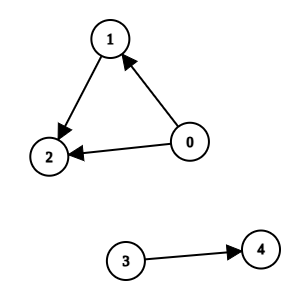
输入: n = 5, k = 0, invocations = [[1,2],[0,2],[0,1],[3,4]]
输出: [3,4]
解释:
方法 0、方法 1 和方法 2 是可疑方法,且没有被任何其他方法直接调用。我们可以移除它们。

示例 3:

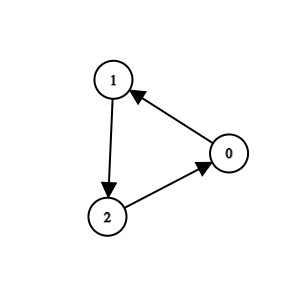
输入: n = 3, k = 2, invocations = [[1,2],[0,1],[2,0]]
输出: []
解释:
所有方法都是可疑方法。我们可以移除它们。

说明:

  • 1 <= n <= 10^5
  • 0 <= k <= n - 1
  • 0 <= invocations.length <= 2 * 10^5
  • invocations[i] == [ai, bi]
  • 0 <= ai, bi <= n - 1
  • ai != bi
  • invocations[i] != invocations[j]

思路

有 n 个方法,编号为 0 ~ n - 1,invocations[i] = [ai, bi] 表示方法 ai 调用了方法 bi。已知方法 k 是可疑的,所有被 k 直接或间接调用的方法也都是可疑的。这些可疑方法如果没有被其它非可疑方法调用可以全部移除,返回剩余的方法。

先标记 k 直接或间接调用的方法,再从所有非可疑方法出发,判断是否会调用可疑方法。如果会调用,不可移除,否则直接返回所有非可疑方法。

代码


/**
 * @date 2026-08-05 9:17
 */
public class RemainingMethods3310 {

    public List<Integer> remainingMethods(int n, int k, int[][] invocations) {
        List<Integer>[] g = new ArrayList[n];
        Arrays.setAll(g, x -> new ArrayList<>());
        for (int[] i : invocations) {
            g[i[0]].add(i[1]);
        }
        boolean[] remove = new boolean[n];
        boolean[] visited = new boolean[n];
        dfs(k, g, remove);
        boolean canRemove = true;
        for (int i = 0; i < n; i++) {
            if (remove[i]) {
                continue;
            }
            if (dfs(i, g, visited, remove)) {
                canRemove = false;
            }
        }
        List<Integer> res = new ArrayList<>();
        for (int i = 0; i < n; i++) {
            if (!canRemove) {
                res.add(i);
            } else if (!remove[i]) {
                res.add(i);
            }
        }
        return res;
    }

    public void dfs(int m, List<Integer>[] g, boolean[] remove) {
        if (remove[m]) {
            return;
        }
        remove[m] = true;
        for (Integer next : g[m]) {
            dfs(next, g, remove);
        }
    }

    public boolean dfs(int m, List<Integer>[] g, boolean[] visited, boolean[] remove) {
        visited[m] = true;
        if (remove[m]) {
            return true;
        }
        boolean res = false;
        for (Integer next : g[m]) {
            if (!visited[next]) {
                res = res || dfs(next, g, visited, remove);
            }
        }
        return res;
    }

}

性能

2685.统计完全连通分量的数量

目标

给你一个整数 n 。现有一个包含 n 个顶点的 无向 图,顶点按从 0 到 n - 1 编号。给你一个二维整数数组 edges 其中 edges[i] = [ai, bi] 表示顶点 ai 和 bi 之间存在一条 无向 边。

返回图中 完全连通分量 的数量。

如果在子图中任意两个顶点之间都存在路径,并且子图中没有任何一个顶点与子图外部的顶点共享边,则称其为 连通分量 。

如果连通分量中每对节点之间都存在一条边,则称其为 完全连通分量 。

示例 1:

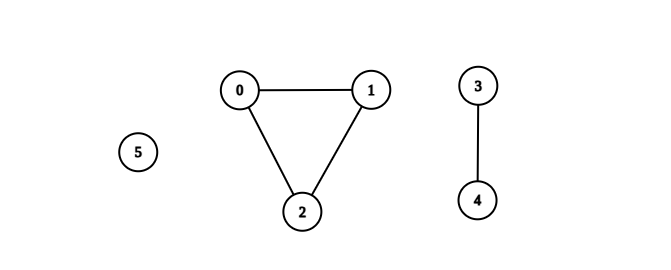
输入:n = 6, edges = [[0,1],[0,2],[1,2],[3,4]]
输出:3
解释:如上图所示,可以看到此图所有分量都是完全连通分量。

示例 2:

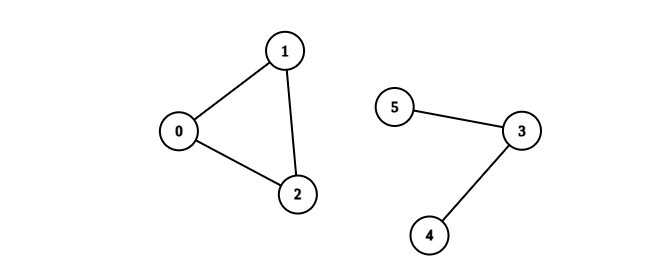
输入:n = 6, edges = [[0,1],[0,2],[1,2],[3,4],[3,5]]
输出:1
解释:包含节点 0、1 和 2 的分量是完全连通分量,因为每对节点之间都存在一条边。
包含节点 3 、4 和 5 的分量不是完全连通分量,因为节点 4 和 5 之间不存在边。
因此,在图中完全连接分量的数量是 1 。

说明:

  • 1 <= n <= 50
  • 0 <= edges.length <= n * (n - 1) / 2
  • edges[i].length == 2
  • 0 <= ai, bi <= n - 1
  • ai != bi
  • 不存在重复的边

思路

求无向图中完全连通分量的个数。完全连通分量指连通分量中任意两个节点之间都有一条边。

暴力解法是使用并查集维护连通分量,找出同一连通分量内的节点,判断两两之间是否有边。

优化点:可以利用节点与边的关系来判断是否是完全连通分量,节点 v 与 边 e 的关系为:e = C(v, 2) = v * (v - 1) / 2。

代码


/**
 * @date 2026-07-14 11:27
 */
public class CountCompleteComponents2685 {

    private class UnionFind {

        private final int[] fa;

        public UnionFind(int n) {
            fa = new int[n];
            Arrays.setAll(fa, i -> i);
        }

        public int find(int e) {
            if (e != fa[e]) {
                fa[e] = find(fa[e]);
            }
            return fa[e];
        }

        public void union(int a, int b) {
            int x = find(a);
            int y = find(b);
            if (x > y) {
                fa[x] = y;
            } else {
                fa[y] = x;
            }
        }

        public int getCompleteComponents(Set<Integer>[] g) {
            int n = fa.length;
            int res = 0;
            Set<Integer> visited = new HashSet<>();
            for (int i = 0; i < n; i++) {
                if (visited.contains(i)) {
                    continue;
                }
                visited.add(i);
                List<Integer> list = new ArrayList<>();
                for (int j = 0; j < n; j++) {
                    if (find(j) == find(i)) {
                        visited.add(j);
                        list.add(j);
                    }
                }
                int size = list.size();
                boolean flag = true;
                here:
                for (int p = 0; p < size; p++) {
                    for (int q = p + 1; q < size; q++) {
                        if (!g[list.get(p)].contains(list.get(q))) {
                            flag = false;
                            break here;
                        }
                    }
                }
                if (flag) {
                    res++;
                }
            }
            return res;
        }
    }

    public int countCompleteComponents(int n, int[][] edges) {
        UnionFind uf = new UnionFind(n);
        Set<Integer>[] g = new HashSet[n];
        Arrays.setAll(g, x -> new HashSet<>());
        for (int[] edge : edges) {
            int a = edge[0];
            int b = edge[1];
            uf.union(a, b);
            g[a].add(b);
            g[b].add(a);
        }
        return uf.getCompleteComponents(g);
    }

}

性能

2492.两个城市间路径的最小分数

目标

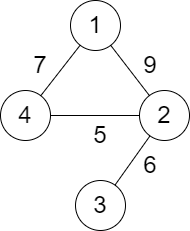
给你一个正整数 n ,表示总共有 n 个城市,城市从 1 到 n 编号。给你一个二维数组 roads ,其中 roads[i] = [ai, bi, distancei] 表示城市 ai 和 bi 之间有一条 双向 道路,道路距离为 distancei 。城市构成的图不一定是连通的。

两个城市之间一条路径的 分数 定义为这条路径中道路的 最小 距离。

返回城市 1 和城市 n 之间的所有路径的 最小 分数。

注意:

  • 一条路径指的是两个城市之间的道路序列。
  • 一条路径可以 多次 包含同一条道路,你也可以沿着路径多次到达城市 1 和城市 n 。
  • 测试数据保证城市 1 和城市n 之间 至少 有一条路径。

示例 1:

输入:n = 4, roads = [[1,2,9],[2,3,6],[2,4,5],[1,4,7]]
输出:5
解释:城市 1 到城市 4 的路径中,分数最小的一条为:1 -> 2 -> 4 。这条路径的分数是 min(9,5) = 5 。
不存在分数更小的路径。

示例 2:

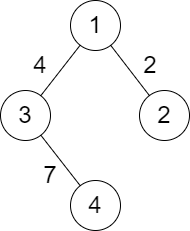
输入:n = 4, roads = [[1,2,2],[1,3,4],[3,4,7]]
输出:2
解释:城市 1 到城市 4 分数最小的路径是:1 -> 2 -> 1 -> 3 -> 4 。这条路径的分数是 min(2,2,4,7) = 2 。

说明:

  • 2 <= n <= 10^5
  • 1 <= roads.length <= 10^5
  • roads[i].length == 3
  • 1 <= ai, bi <= n
  • ai != bi
  • 1 <= distancei <= 10^4
  • 不会有重复的边。
  • 城市 1 和城市 n 之间至少有一条路径。

思路

单源最短路径,可以使用 Dijkstra 算法。但是需要注意,这里求的不是路径和的最小值,而是从城市 1 出发,每段路径的最小值。

从城市 1 开始 dfs 访问所能到达的城市,记录路径中的最小值。需要注意,虽然城市可能已访问过,但是边仍可能是未处理的,比如 1 -> 2 -> 3 -> 1,3 -> 1 这条路径也应该参与最终结果的计算,因此需要先比较再判断是否访问过。

代码


/**
 * @date 2026-07-06 11:35
 */
public class MinScore2492 {

    public int minScore(int n, int[][] roads) {
        List<int[]>[] g = new List[n + 1];
        Arrays.setAll(g, x -> new ArrayList<>());
        for (int[] road : roads) {
            g[road[0]].add(new int[]{road[1], road[2]});
            g[road[1]].add(new int[]{road[0], road[2]});
        }
        boolean[] visited = new boolean[n + 1];
        return dfs(1, g, visited);
    }

    public int dfs(int cur, List<int[]>[] g, boolean[] visited) {
        int res = Integer.MAX_VALUE;
        visited[cur] = true;
        for (int[] next : g[cur]) {
            res = Math.min(res, next[1]);
            if (visited[next[0]]) {
                continue;
            }
            res = Math.min(dfs(next[0], g, visited), res);
        }
        return res;
    }

}

性能

3558.给边赋权值的方案数I

目标

给你一棵 n 个节点的无向树,节点从 1 到 n 编号,树以节点 1 为根。树由一个长度为 n - 1 的二维整数数组 edges 表示,其中 edges[i] = [ui, vi] 表示在节点 ui 和 vi 之间有一条边。

一开始,所有边的权重为 0。你可以将每条边的权重设为 1 或 2。

两个节点 u 和 v 之间路径的 代价 是连接它们路径上所有边的权重之和。

选择任意一个 深度最大 的节点 x。返回从节点 1 到 x 的路径中,边权重之和为 奇数 的赋值方式数量。

由于答案可能很大,返回它对 10^9 + 7 取模的结果。

注意: 忽略从节点 1 到节点 x 的路径外的所有边。

示例 1:

输入: edges = [[1,2]]
输出: 1
解释:
从节点 1 到节点 2 的路径有一条边(1 → 2)。
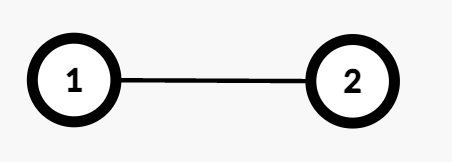
将该边赋权为 1 会使代价为奇数,赋权为 2 则为偶数。因此,合法的赋值方式有 1 种。

示例 2:

输入: edges = [[1,2],[1,3],[3,4],[3,5]]
输出: 2
解释:
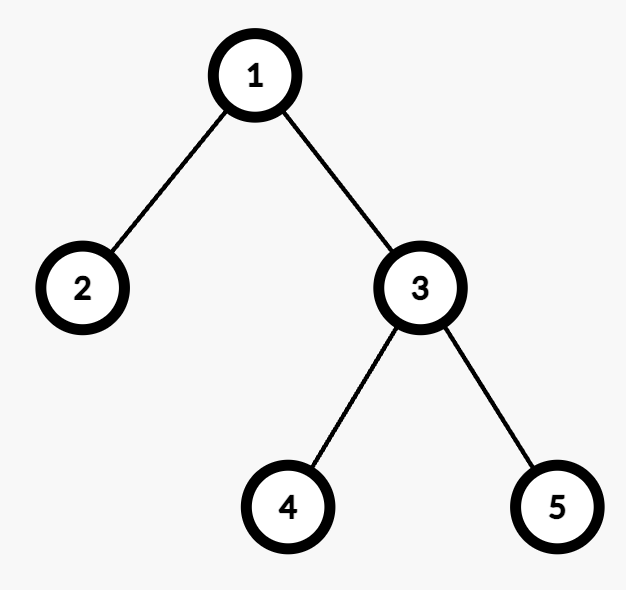
最大深度为 2,节点 4 和节点 5 都在该深度,可以选择任意一个。
例如,从节点 1 到节点 4 的路径包括两条边(1 → 3 和 3 → 4)。
将两条边赋权为 (1,2) 或 (2,1) 会使代价为奇数,因此合法赋值方式有 2 种。

提示:

  • 2 <= n <= 10^5
  • edges.length == n - 1
  • edges[i] == [ui, vi]
  • 1 <= ui, vi <= n
  • edges 表示一棵合法的树。

思路

有一颗含有 n 个节点的树,编号为 1 ~ n,根节点编号是 1。edges[i] = [ui, vi],表示节点 ui 与 vi 之间有一条边。定义节点 u 与 v 之间的代价为它们之间路径上边的权重之和。可以为每一条边赋予权重 1 或 2,求使得根节点到最远叶子节点代价为奇数的赋权方案数。

定义到达当前节点代价为奇数或偶数的方案数为 dp[i][1] 与 dp[i][0],状态转移方程为 dp[i][0] = dp[prev][0] + dp[prev][1],dp[i][1] = dp[prev][0] + dp[prev][1]。

观察发现 dp[i][0] == dp[i][1],因此代价为奇数的方案数为 dp[i][1] = 2 * dp[prev][1]。假设树的深度为 d,方案数为 2^(d - 1)。

求出树的深度 d,从中选取奇数条边赋值为 1,方案数为 2^(d - 1)。

代码


/**
 * @date 2026-06-11 10:16
 */
public class AssignEdgeWeights3558 {

    public int assignEdgeWeights(int[][] edges) {
        int n = edges.length + 1;
        List<Integer>[] g = new ArrayList[n + 1];
        Arrays.setAll(g, i -> new ArrayList<>());
        for (int[] edge : edges) {
            g[edge[0]].add(edge[1]);
            g[edge[1]].add(edge[0]);
        }
        int d = dfs(0, 1, g);
        return pow(2, d - 1, 1000000007);
    }

    public int dfs(int fa, int cur, List<Integer>[] g) {
        int res = 0;
        for (Integer next : g[cur]) {
            if (next == fa) {
                continue;
            }
            res = Math.max(res, dfs(cur, next, g) + 1);
        }
        return res;
    }

    public int pow(int base, int exp, int mod) {
        long res = 1L;
        while (exp > 0) {
            if ((exp & 1) == 1) {
                res = res * base % mod;
            }
            base = (int) ((long) base * base % mod);
            exp >>= 1;
        }
        return (int) res;
    }

}

性能

1306.跳跃游戏III

目标

给定一个非负整数数组 arr,你最开始位于该数组的起始下标 start 处。当你位于下标 i 处时,你可以跳到 i + arr[i] 或者 i - arr[i]。

请你判断自己是否能够跳到对应元素值为 0 的 任一 下标处。

注意,不管是什么情况下,你都无法跳到数组之外。

示例 1:

输入:arr = [4,2,3,0,3,1,2], start = 5
输出:true
解释:
到达值为 0 的下标 3 有以下可能方案: 
下标 5 -> 下标 4 -> 下标 1 -> 下标 3 
下标 5 -> 下标 6 -> 下标 4 -> 下标 1 -> 下标 3 

示例 2:

输入:arr = [4,2,3,0,3,1,2], start = 0
输出:true 
解释:
到达值为 0 的下标 3 有以下可能方案: 
下标 0 -> 下标 4 -> 下标 1 -> 下标 3

示例 3:

输入:arr = [3,0,2,1,2], start = 2
输出:false
解释:无法到达值为 0 的下标 1 处。 

说明:

  • 1 <= arr.length <= 5 * 10^4
  • 0 <= arr[i] < arr.length
  • 0 <= start < arr.length

思路

有一个数组 arr,起始位于 start,每次跳跃可以到达 i + arr[i] 或者 i - arr[i] 的下标,判断能否跳到任一一个元素值为 0 的下标。

从 start 开始 dfs,记录访问过的下标,并判断元素值是否为 0。

代码


/**
 * @date 2026-05-18 10:53
 */
public class CanReach1306 {

    public boolean canReach(int[] arr, int start) {
        boolean[] visited = new boolean[arr.length];
        return dfs(arr, start, visited);
    }

    public boolean dfs(int[] arr, int cur, boolean[] visited) {
        if (cur < 0 || cur >= arr.length || visited[cur]) {
            return false;
        }
        if (arr[cur] == 0) {
            return true;
        }
        visited[cur] = true;
        return dfs(arr, cur + arr[cur], visited) || dfs(arr, cur - arr[cur], visited);
    }
}

性能

1391.检查网格中是否存在有效路径

目标

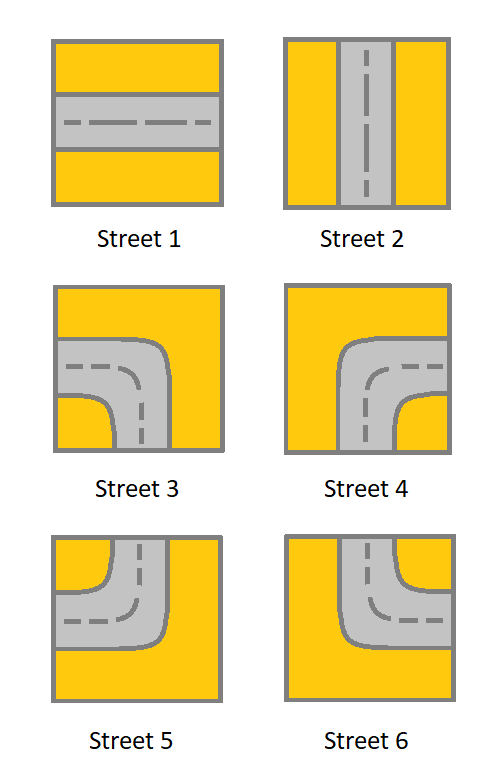
给你一个 m x n 的网格 grid。网格里的每个单元都代表一条街道。grid[i][j] 的街道可以是:

  • 1 表示连接左单元格和右单元格的街道。
  • 2 表示连接上单元格和下单元格的街道。
  • 3 表示连接左单元格和下单元格的街道。
  • 4 表示连接右单元格和下单元格的街道。
  • 5 表示连接左单元格和上单元格的街道。
  • 6 表示连接右单元格和上单元格的街道。

你最开始从左上角的单元格 (0,0) 开始出发,网格中的「有效路径」是指从左上方的单元格 (0,0) 开始、一直到右下方的 (m-1,n-1) 结束的路径。该路径必须只沿着街道走。

注意:你 不能 变更街道。

如果网格中存在有效的路径,则返回 true,否则返回 false 。

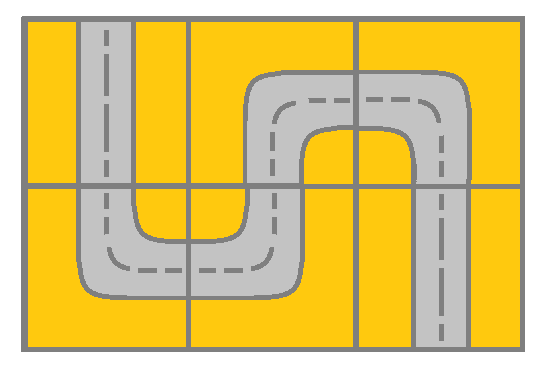
示例 1:

输入:grid = [[2,4,3],[6,5,2]]
输出:true
解释:如图所示,你可以从 (0, 0) 开始,访问网格中的所有单元格并到达 (m - 1, n - 1) 。

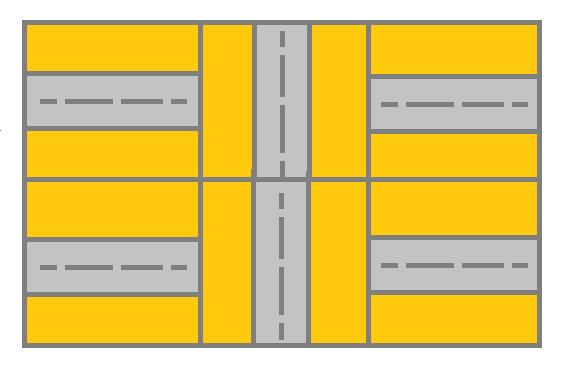
示例 2:

输入:grid = [[1,2,1],[1,2,1]]
输出:false
解释:如图所示,单元格 (0, 0) 上的街道没有与任何其他单元格上的街道相连,你只会停在 (0, 0) 处。

示例 3:

输入:grid = [[1,1,2]]
输出:false
解释:你会停在 (0, 1),而且无法到达 (0, 2) 。

示例 4:

输入:grid = [[1,1,1,1,1,1,3]]
输出:true

示例 5:

输入:grid = [[2],[2],[2],[2],[2],[2],[6]]
输出:true

提示:

  • m == grid.length
  • n == grid[i].length
  • 1 <= m, n <= 300
  • 1 <= grid[i][j] <= 6

思路

有一个二维矩阵 grid,每个单元格的值都代表一种街道类型,判断能否从左上角出发沿着街道走到右下角。

根据当前的街道类型,初始化可走的方向,同时判断下一个位置是否超出了边界,是否访问过,是否与当前街道连通。

代码


/**
 * @date 2026-04-27 9:08
 */
public class HasValidPath1391 {

    public boolean hasValidPath(int[][] grid) {
        int m = grid.length;
        int n = grid[0].length;
        boolean[][] visited = new boolean[m][n];
        return dfs(0, 0, new int[]{1, 2, 3, 4, 5, 6}, visited, grid);
    }

    public static int[][][] directions = new int[][][]{
            {{0, 0}, {0, 0}},
            {{0, -1}, {0, 1}},
            {{-1, 0}, {1, 0}},
            {{0, -1}, {1, 0}},
            {{0, 1}, {1, 0}},
            {{0, -1}, {-1, 0}},
            {{0, 1}, {-1, 0}},
    };

    public static int[][][] allowedTypes = new int[][][]{
            {{}},
            {{1, 4, 6}, {1, 3, 5}},
            {{2, 3, 4}, {2, 5, 6}},
            {{1, 4, 6}, {2, 5, 6}},
            {{1, 3, 5}, {2, 5, 6}},
            {{1, 4, 6}, {2, 3, 4}},
            {{1, 3, 5}, {2, 3, 4}},
    };

    public boolean dfs(int row, int col, int[] types, boolean[][] visited, int[][] grid) {
        int m = grid.length;
        int n = grid[0].length;
        if (row == m || row < 0 || col == n || col < 0 || visited[row][col]) {
            return false;
        }
        visited[row][col] = true;
        int type = grid[row][col];
        boolean valid = false;
        for (int t : types) {
            if (t == type) {
                valid = true;
                break;
            }
        }
        if (!valid) {
            return false;
        }
        boolean res = row == m - 1 && col == n - 1;
        for (int i = 0; i < directions[type].length; i++) {
            res = res || dfs(row + directions[type][i][0], col + directions[type][i][1], allowedTypes[type][i], visited, grid);
        }
        return res;
    }

}

性能