486.预测赢家

目标

给你一个整数数组 nums 。玩家 1 和玩家 2 基于这个数组设计了一个游戏。

玩家 1 和玩家 2 轮流进行自己的回合,玩家 1 先手。开始时,两个玩家的初始分值都是 0 。每一回合,玩家从数组的任意一端取一个数字(即,nums[0] 或 nums[nums.length - 1]),取到的数字将会从数组中移除(数组长度减 1 )。玩家选中的数字将会加到他的得分上。当数组中没有剩余数字可取时,游戏结束。

如果玩家 1 能成为赢家,返回 true 。如果两个玩家得分相等,同样认为玩家 1 是游戏的赢家,也返回 true 。你可以假设每个玩家的玩法都会使他的分数最大化。

示例 1:

输入:nums = [1,5,2]
输出:false
解释:一开始,玩家 1 可以从 1 和 2 中进行选择。
如果他选择 2(或者 1 ),那么玩家 2 可以从 1(或者 2 )和 5 中进行选择。如果玩家 2 选择了 5 ,那么玩家 1 则只剩下 1(或者 2 )可选。 
所以,玩家 1 的最终分数为 1 + 2 = 3,而玩家 2 为 5 。
因此,玩家 1 永远不会成为赢家,返回 false 。

示例 2:

输入:nums = [1,5,233,7]
输出:true
解释:玩家 1 一开始选择 1 。然后玩家 2 必须从 5 和 7 中进行选择。无论玩家 2 选择了哪个,玩家 1 都可以选择 233 。
最终,玩家 1(234 分)比玩家 2(12 分)获得更多的分数,所以返回 true,表示玩家 1 可以成为赢家。

说明:

  • 1 <= nums.length <= 20
  • 0 <= nums[i] <= 10^7

思路

有一个整数数组 nums,玩家1 先手,从数组任意一端取走一个元素累加到他的得分上,最终积分高的玩家获胜(如果积分相同则先手玩家获胜),每个玩家的玩法都会使他的积分最大,判断 玩家1 能否取得胜利。

定义 dp[i][j] 表示子数组 nums[i:j] 先手玩家与后手玩家所能获得的最大积分之差的最大值。dp[i][j] = max(nums[i] - dp[i + 1][j], nums[j] - dp[i][j - 1])。

代码


/**
 * @date 2026-08-03 14:12
 */
public class PredictTheWinner486 {

    public boolean predictTheWinner_v1(int[] nums) {
        int n = nums.length;
        int[][] dp = new int[n][n];
        for (int i = n - 1; i >= 0; i--) {
            dp[i][i] = nums[i];
            for (int j = i + 1; j < n; j++) {
                dp[i][j] = Math.max(nums[i] - dp[i + 1][j], nums[j] - dp[i][j - 1]);
            }
        }
        return dp[0][n - 1] >= 0;
    }

}

性能
3016.输入单词需要的最少按键次数II

目标

给你一个字符串 word,由小写英文字母组成。

电话键盘上的按键与 不同 小写英文字母集合相映射,可以通过按压按键来组成单词。例如,按键 2 对应 ["a","b","c"],我们需要按一次键来输入 "a",按两次键来输入 "b",按三次键来输入 "c"。

现在允许你将编号为 2 到 9 的按键重新映射到 不同 字母集合。每个按键可以映射到 任意数量 的字母,但每个字母 必须 恰好 映射到 一个 按键上。你需要找到输入字符串 word 所需的 最少 按键次数。

返回重新映射按键后输入 word 所需的 最少 按键次数。

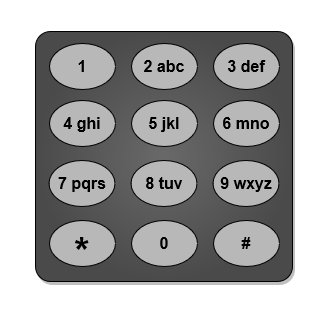
下面给出了一种电话键盘上字母到按键的映射作为示例。注意 1,*,# 和 0 不 对应任何字母。

示例 1:

输入:word = "abcde"
输出:5
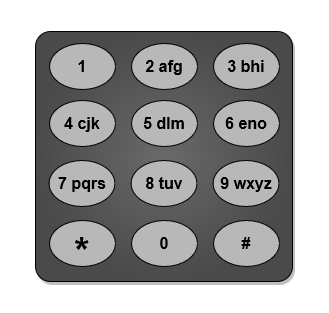
解释:图片中给出的重新映射方案的输入成本最小。
"a" -> 在按键 2 上按一次
"b" -> 在按键 3 上按一次
"c" -> 在按键 4 上按一次
"d" -> 在按键 5 上按一次
"e" -> 在按键 6 上按一次
总成本为 1 + 1 + 1 + 1 + 1 = 5 。
可以证明不存在其他成本更低的映射方案。

示例 2:

输入:word = "xyzxyzxyzxyz"
输出:12
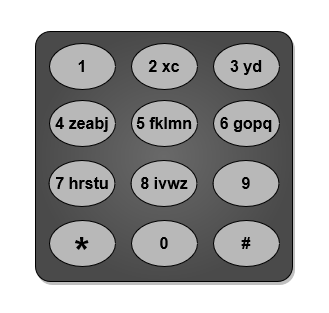
解释:图片中给出的重新映射方案的输入成本最小。
"x" -> 在按键 2 上按一次
"y" -> 在按键 3 上按一次
"z" -> 在按键 4 上按一次
总成本为 1 * 4 + 1 * 4 + 1 * 4 = 12 。
可以证明不存在其他成本更低的映射方案。
注意按键 9 没有映射到任何字母:不必让每个按键都存在与之映射的字母,但是每个字母都必须映射到按键上。

示例 3:

输入:word = "aabbccddeeffgghhiiiiii"
输出:24
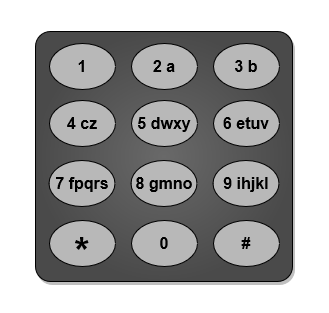
解释:图片中给出的重新映射方案的输入成本最小。
"a" -> 在按键 2 上按一次
"b" -> 在按键 3 上按一次
"c" -> 在按键 4 上按一次
"d" -> 在按键 5 上按一次
"e" -> 在按键 6 上按一次
"f" -> 在按键 7 上按一次
"g" -> 在按键 8 上按一次
"h" -> 在按键 9 上按两次
"i" -> 在按键 9 上按一次
总成本为 1 * 2 + 1 * 2 + 1 * 2 + 1 * 2 + 1 * 2 + 1 * 2 + 1 * 2 + 2 * 2 + 6 * 1 = 24 。
可以证明不存在其他成本更低的映射方案。

说明:

  • 1 <= word.length <= 10^5
  • word 仅由小写英文字母组成。

思路

可以将 26 个字母映射到 2 ~ 9 按键上,比如将 abc 映射到 2,那么输入 b 需要按两下 2,输入 c 需要按三下 2。给定一个单词 word,返回输入该字符所需的最少按键次数。

与 3014.输入单词需要的最少按键次数I 相比,本题并没有说 word 是由不同字母组成。

将字母出现频次从大到小排序,大的优先分配在按键的第一个位置(按一下),然后是第二个位置(按两下),以此类推。

代码


/**
 * @date 2026-07-31 9:02
 */
public class MinimumPushes3016 {

    public int minimumPushes(String word) {
        int[] cnt = new int[26];
        for (char c : word.toCharArray()) {
            cnt[c - 'a']++;
        }
        PriorityQueue<int[]> q = new PriorityQueue<>((a, b) -> b[1] - a[1]);
        for (int i = 0; i < 26; i++) {
            q.offer(new int[]{i, cnt[i]});
        }
        int k = 0;
        int res = 0;
        for (int i = 0; i < 26; i++) {
            int[] e = q.poll();
            if (e[1] == 0) {
                break;
            }
            res += (k++ / 8 + 1) * e[1];
        }
        return res;
    }
}

性能

3517.最小回文排列I

目标

给你一个 回文 字符串 s。

返回 s 的按字典序排列的 最小 回文排列。

如果一个字符串从前往后和从后往前读都相同,那么这个字符串是一个 回文 字符串。

排列 是字符串中所有字符的重排。

如果字符串 a 按字典序小于字符串 b,则表示在第一个不同的位置,a 中的字符比 b 中的对应字符在字母表中更靠前。

如果在前 min(a.length, b.length) 个字符中没有区别,则较短的字符串按字典序更小。

示例 1:

输入: s = "z"
输出: "z"
解释:
仅由一个字符组成的字符串已经是按字典序最小的回文。

示例 2:

输入: s = "babab"
输出: "abbba"
解释:
通过重排 "babab" → "abbba",可以得到按字典序最小的回文。

示例 3:

输入: s = "daccad"
输出: "acddca"
解释:
通过重排 "daccad" → "acddca",可以得到按字典序最小的回文。

说明:

  • 1 <= s.length <= 10^5
  • s 由小写英文字母组成。
  • 保证 s 是回文字符串。

思路

有一个回文字符串 s,将其重新排列成回文字符串,使得字典序最小。

记录字符串中字符的出现次数,然后按字典序从两边向中间填充,如果出现次数为奇数,那么该字符为中间元素。

代码


/**
 * @date 2026-07-28 9:03
 */
public class SmallestPalindrome3517 {

    public String smallestPalindrome(String s) {
        int[] cnt = new int[26];
        int n = s.length();
        char[] res = new char[n];
        for (char c : s.toCharArray()) {
            cnt[c - 'a']++;
        }
        char mid = 0;
        int cur = 0;
        for (int i = 0; i < 26; i++) {
            if (cnt[i] % 2 == 1) {
                mid = (char) ('a' + i);
            }
            int k = cnt[i] / 2;
            char c = (char) ('a' + i);
            for (int j = 0; j < k; j++) {
                res[cur + j] = c;
                res[n - cur - j - 1] = c;
            }
            cur += k;
        }
        if (n % 2 == 1) {
            res[n / 2] = mid;
        }
        return new String(res);
    }

}

性能

3514.不同 XOR 三元组的数目II

目标

给你一个整数数组 nums 。

XOR 三元组 定义为三个元素的异或值 nums[i] XOR nums[j] XOR nums[k],其中 i <= j <= k。

返回所有可能三元组 (i, j, k) 中 不同 的 XOR 值的数量。

示例 1:

输入: nums = [1,3]
输出: 2
解释:
所有可能的 XOR 三元组值为:
(0, 0, 0) → 1 XOR 1 XOR 1 = 1
(0, 0, 1) → 1 XOR 1 XOR 3 = 3
(0, 1, 1) → 1 XOR 3 XOR 3 = 1
(1, 1, 1) → 3 XOR 3 XOR 3 = 3
不同的 XOR 值为 {1, 3} 。因此输出为 2 。

示例 2:

输入: nums = [6,7,8,9]
输出: 4
解释:
不同的 XOR 值为 {6, 7, 8, 9} 。因此输出为 4 。

说明:

1 <= nums.length <= 1500
1 <= nums[i] <= 1500

思路

有一个正整数数组 nums,从中取三个数(可重复)的异或值 XOR,求不同的 XOR 值有多少个。

暴力枚举。

代码


/**
 * @date 2026-07-24 9:12
 */
public class UniqueXorTriplets3514 {

    public int uniqueXorTriplets(int[] nums) {
        int n = nums.length;
        int max = 0;
        for (int num : nums) {
            max = Math.max(max, num);
        }
        int upper = 1 << (32 - Integer.numberOfLeadingZeros(max));
        boolean[] tmp = new boolean[upper];
        boolean[] arr = new boolean[upper];
        for (int i = 0; i < n; i++) {
            for (int j = i; j < n; j++) {
                tmp[nums[i] ^ nums[j]] = true;
            }
        }
        for (int i = 0; i < upper; i++) {
            if (tmp[i]) {
                for (int num : nums) {
                    arr[num ^ i] = true;
                }
            }
        }
        int res = 0;
        for (boolean b : arr) {
            if (b) {
                res++;
            }
        }
        return res;
    }

}

性能

3513.不同 XOR 三元组的数目I

目标

给你一个长度为 n 的整数数组 nums,其中 nums 是范围 [1, n] 内所有数的 排列 。

XOR 三元组 定义为三个元素的异或值 nums[i] XOR nums[j] XOR nums[k],其中 i <= j <= k。

返回所有可能三元组 (i, j, k) 中 不同 的 XOR 值的数量。

排列 是一个集合中所有元素的重新排列。

示例 1:

输入: nums = [1,2]
输出: 2
解释:
所有可能的 XOR 三元组值为:
(0, 0, 0) → 1 XOR 1 XOR 1 = 1
(0, 0, 1) → 1 XOR 1 XOR 2 = 2
(0, 1, 1) → 1 XOR 2 XOR 2 = 1
(1, 1, 1) → 2 XOR 2 XOR 2 = 2
不同的 XOR 值为 {1, 2},因此输出为 2。

示例 2:

输入: nums = [3,1,2]
输出: 4
解释:
可能的 XOR 三元组值包括:
(0, 0, 0) → 3 XOR 3 XOR 3 = 3
(0, 0, 1) → 3 XOR 3 XOR 1 = 1
(0, 0, 2) → 3 XOR 3 XOR 2 = 2
(0, 1, 2) → 3 XOR 1 XOR 2 = 0
不同的 XOR 值为 {0, 1, 2, 3},因此输出为 4。

说明:

  • 1 <= n == nums.length <= 10^5
  • 1 <= nums[i] <= n
  • nums 是从 1 到 n 的整数的一个排列。

思路

有一个 1 ~ n 的排列,从中取三个数(可重复)的异或值 XOR,求不同的 XOR 值有多少个。

可以构造出 0 ~ 2^(k + 1) - 1 之间的任意数字,其中 k 是从右向左的最高位(从 0 开始)。

代码


/**
 * @date 2026-07-23 9:55
 */
public class UniqueXorTriplets3513 {

    public int uniqueXorTriplets(int[] nums) {
        int n = nums.length;
        return n <= 2 ? n : 1 << (32 - Integer.numberOfLeadingZeros(n));
    }
}

性能

3499.操作后最大活跃区段数I

目标

给你一个长度为 n 的二进制字符串 s,其中:

  • '1' 表示一个 活跃 区段。
  • '0' 表示一个 非活跃 区段。

你可以执行 最多一次操作 来最大化 s 中的活跃区段数量。在一次操作中,你可以:

  • 将一个被 '0' 包围的连续 '1' 区块转换为全 '0'。
  • 然后,将一个被 '1' 包围的连续 '0' 区块转换为全 '1'。

返回在执行最优操作后,s 中的 最大 活跃区段数。

注意:处理时需要在 s 的两侧加上 '1' ,即 t = '1' + s + '1'。这些加上的 '1' 不会影响最终的计数。

示例 1:

输入: s = "01"
输出: 1
解释:
因为没有被 '0' 包围的 '1' 区块,因此无法进行有效操作。最大活跃区段数为 1。

示例 2:

输入: s = "0100"
输出: 4
解释:
字符串 "0100" → 两端加上 '1' 后得到 "101001" 。
选择 "0100","101001" → "100001" → "111111" 。
最终的字符串去掉两端的 '1' 后为 "1111" 。最大活跃区段数为 4。

示例 3:

输入: s = "1000100"
输出: 7
解释:
字符串 "1000100" → 两端加上 '1' 后得到 "110001001" 。
选择 "000100","110001001" → "110000001" → "111111111"。
最终的字符串去掉两端的 '1' 后为 "1111111"。最大活跃区段数为 7。

示例 4:

输入: s = "01010"
输出: 4
解释:
字符串 "01010" → 两端加上 '1' 后得到 "1010101"。
选择 "010","1010101" → "1000101" → "1111101"。
最终的字符串去掉两端的 '1' 后为 "11110"。最大活跃区段数为 4。

说明:

  • 1 <= n == s.length <= 10^5
  • s[i] 仅包含 '0' 或 '1'

思路

有一个二进制字符串,在其首尾拼上 1,然后执行一次操作:将一个被 0 包围的连续 1 全部转为 0,然后将一个被 1 包围的连续 0 全部转为 1,求操作之后 字符串 中 1 的最大个数(不包括首尾拼接的 1)。

实际上是求字符串中 1 两侧连续 0 的最大长度。

判断 01 分界,记录之前连续 0 的个数与当前连续 0 的个数之和的最大值。

代码


/**
 * @date 2026-07-21 10:41
 */
public class MaxActiveSectionsAfterTrade3499 {

    public int maxActiveSectionsAfterTrade(String s) {
        int n = s.length();
        int prevZero = 0;
        int curZero = 0;
        int oneCnt = 0;
        int max = 0;
        for (int i = 0; i < n; i++) {
            if (s.charAt(i) == '1') {
                oneCnt++;
                if (curZero > 0) {
                    if (prevZero > 0) {
                        max = Math.max(max, curZero + prevZero);
                    }
                    prevZero = curZero;
                    curZero = 0;
                }
            } else {
                curZero++;
            }
        }
        if (curZero > 0) {
            if (prevZero > 0) {
                max = Math.max(max, curZero + prevZero);
            }
        }
        return oneCnt + max;
    }

}

性能

3867.数对的最大公约数之和

目标

给你一个长度为 n 的整数数组 nums。

构造一个数组 prefixGcd,其中对于每个下标 i:

  • 令 mxi = max(nums[0], nums[1], ..., nums[i])。
  • prefixGcd[i] = gcd(nums[i], mxi)。

在构造 prefixGcd 之后:

  • 将 prefixGcd 按 非递减 顺序排序。
  • 通过取 最小的未配对 元素和 最大的未配对 元素来形成数对。
  • 重复此过程,直到无法再形成更多数对。
  • 对于每个形成的数对,计算 两个元素的最大公约数 gcd。
  • 如果 n 是奇数,prefixGcd 数组中的 中间 元素保持 未配对 状态,并应被忽略。

返回一个整数,表示所有形成数对的 最大公约数之和。

术语 gcd(a, b) 表示 a 和 b 的 最大公约数。

示例 1:

输入: nums = [2,6,4]
输出: 2
解释:
构造 prefixGcd:
i nums[i] mxi prefixGcd[i]
0    2    2      2
1    6    6      6
2    4    6      2
prefixGcd = [2, 6, 2]。排序后形成 [2, 2, 6]。
将最小和最大的元素配对:gcd(2, 6) = 2。剩下的中间元素 2 被忽略。因此,总和为 2。

示例 2:

输入: nums = [3,6,2,8]
输出: 5
解释:
构造 prefixGcd:
i nums[i] mxi prefixGcd[i]
0    3     3      3
1    6     6      6
2    2     6      2
3    8     8      8
prefixGcd = [3, 6, 2, 8]。排序后形成 [2, 3, 6, 8]。
形成数对:gcd(2, 8) = 2 和 gcd(3, 6) = 3。因此,总和为 2 + 3 = 5。

说明:

  • 1 <= n == nums.length <= 10^5
  • 1 <= nums[i] <= 10^9

思路

有一个正整数数组 nums,构造数组 prefixGcd,prefixGcd[i] = gcd(maxi, nums[i]),其中 maxi 为 [0, i] 的最大值。将 prefixGcd 排序后首尾配对,忽略中间未配对元素,求每对 gcd 之和。

根据题目模拟即可。

代码


/**
 * @date 2026-07-16 9:34
 */
public class GcdSum3867 {

    public long gcdSum(int[] nums) {
        int n = nums.length;
        int[] prefixGcd = new int[n];
        int max = 0;
        for (int i = 0; i < n; i++) {
            max = Math.max(max, nums[i]);
            prefixGcd[i] = gcd(max, nums[i]);
        }
        Arrays.sort(prefixGcd);
        long res = 0;
        int l = 0, r = n - 1;
        while (l < r) {
            res += gcd(prefixGcd[l++], prefixGcd[r--]);
        }
        return res;
    }

    public int gcd(int a, int b) {
        while (b != 0) {
            int tmp = b;
            b = a % b;
            a = tmp;
        }
        return a;
    }
}

性能

1291.顺次数

目标

我们定义「顺次数」为:每一位上的数字都比前一位上的数字大 1 的整数。

请你返回由 [low, high] 范围内所有顺次数组成的 有序 列表(从小到大排序)。

示例 1:

输出:low = 100, high = 300
输出:[123,234]

示例 2:

输出:low = 1000, high = 13000
输出:[1234,2345,3456,4567,5678,6789,12345]

说明:

  • 10 <= low <= high <= 10^9

思路

定义顺序数字为从左到右每一位都比前一位的数字大 1 的整数。返回 [low, high] 范围内的所有顺序数字,按从小到大返回。

枚举数字长度以及开头数字,判断生成的顺序数字是否在 [low, high] 内即可。

代码


/**
 * @date 2026-07-13 9:10
 */
public class SequentialDigits1291 {

    public List<Integer> sequentialDigits(int low, int high) {
        int l = Integer.toString(low).length();
        int r = Integer.toString(high).length();
        List<Integer> res = new ArrayList<>();
        for (int i = l; i <= r; i++) {
            for(int j = 1; j + i <= 10; j++){
                Integer num = genInteger(j, i);
                if (low <= num && num <= high){
                    res.add(num);
                }
            }
        }
        return res;
    }

    public Integer genInteger(int first, int length) {
        int res = 0;
        for (int i = 0; i < length && first < 10; i++) {
            res = res * 10 + first;
            first++;
        }
        return res;
    }

}

性能

2685.统计完全连通分量的数量

目标

给你一个整数 n 。现有一个包含 n 个顶点的 无向 图,顶点按从 0 到 n - 1 编号。给你一个二维整数数组 edges 其中 edges[i] = [ai, bi] 表示顶点 ai 和 bi 之间存在一条 无向 边。

返回图中 完全连通分量 的数量。

如果在子图中任意两个顶点之间都存在路径,并且子图中没有任何一个顶点与子图外部的顶点共享边,则称其为 连通分量 。

如果连通分量中每对节点之间都存在一条边,则称其为 完全连通分量 。

示例 1:

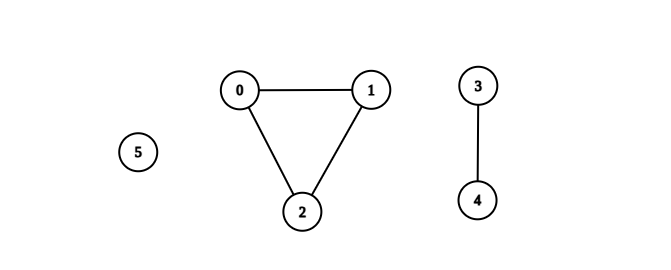
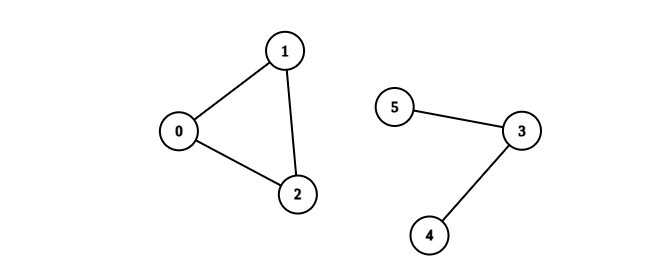
输入:n = 6, edges = [[0,1],[0,2],[1,2],[3,4]]
输出:3
解释:如上图所示,可以看到此图所有分量都是完全连通分量。

示例 2:

输入:n = 6, edges = [[0,1],[0,2],[1,2],[3,4],[3,5]]
输出:1
解释:包含节点 0、1 和 2 的分量是完全连通分量,因为每对节点之间都存在一条边。
包含节点 3 、4 和 5 的分量不是完全连通分量,因为节点 4 和 5 之间不存在边。
因此,在图中完全连接分量的数量是 1 。

说明:

  • 1 <= n <= 50
  • 0 <= edges.length <= n * (n - 1) / 2
  • edges[i].length == 2
  • 0 <= ai, bi <= n - 1
  • ai != bi
  • 不存在重复的边

思路

求无向图中完全连通分量的个数。完全连通分量指连通分量中任意两个节点之间都有一条边。

暴力解法是使用并查集维护连通分量,找出同一连通分量内的节点,判断两两之间是否有边。

优化点:可以利用节点与边的关系来判断是否是完全连通分量,节点 v 与 边 e 的关系为:e = C(v, 2) = v * (v - 1) / 2。

代码


/**
 * @date 2026-07-14 11:27
 */
public class CountCompleteComponents2685 {

    private class UnionFind {

        private final int[] fa;

        public UnionFind(int n) {
            fa = new int[n];
            Arrays.setAll(fa, i -> i);
        }

        public int find(int e) {
            if (e != fa[e]) {
                fa[e] = find(fa[e]);
            }
            return fa[e];
        }

        public void union(int a, int b) {
            int x = find(a);
            int y = find(b);
            if (x > y) {
                fa[x] = y;
            } else {
                fa[y] = x;
            }
        }

        public int getCompleteComponents(Set<Integer>[] g) {
            int n = fa.length;
            int res = 0;
            Set<Integer> visited = new HashSet<>();
            for (int i = 0; i < n; i++) {
                if (visited.contains(i)) {
                    continue;
                }
                visited.add(i);
                List<Integer> list = new ArrayList<>();
                for (int j = 0; j < n; j++) {
                    if (find(j) == find(i)) {
                        visited.add(j);
                        list.add(j);
                    }
                }
                int size = list.size();
                boolean flag = true;
                here:
                for (int p = 0; p < size; p++) {
                    for (int q = p + 1; q < size; q++) {
                        if (!g[list.get(p)].contains(list.get(q))) {
                            flag = false;
                            break here;
                        }
                    }
                }
                if (flag) {
                    res++;
                }
            }
            return res;
        }
    }

    public int countCompleteComponents(int n, int[][] edges) {
        UnionFind uf = new UnionFind(n);
        Set<Integer>[] g = new HashSet[n];
        Arrays.setAll(g, x -> new HashSet<>());
        for (int[] edge : edges) {
            int a = edge[0];
            int b = edge[1];
            uf.union(a, b);
            g[a].add(b);
            g[b].add(a);
        }
        return uf.getCompleteComponents(g);
    }

}

性能

3532.针对图的路径存在性查询I

目标

给你一个整数 n,表示图中的节点数量,这些节点按从 0 到 n - 1 编号。

同时给你一个长度为 n 的整数数组 nums,该数组按 非递减 顺序排序,以及一个整数 maxDiff。

如果满足 |nums[i] - nums[j]| <= maxDiff(即 nums[i] 和 nums[j] 的 绝对差 至多为 maxDiff),则节点 i 和节点 j 之间存在一条 无向边 。

此外,给你一个二维整数数组 queries。对于每个 queries[i] = [ui, vi],需要判断节点 ui 和 vi 之间是否存在路径。

返回一个布尔数组 answer,其中 answer[i] 等于 true 表示在第 i 个查询中节点 ui 和 vi 之间存在路径,否则为 false。

示例 1:

输入: n = 2, nums = [1,3], maxDiff = 1, queries = [[0,0],[0,1]]
输出: [true,false]
解释:
查询 [0,0]:节点 0 有一条到自己的显然路径。
查询 [0,1]:节点 0 和节点 1 之间没有边,因为 |nums[0] - nums[1]| = |1 - 3| = 2,大于 maxDiff。
因此,在处理完所有查询后,最终答案为 [true, false]。

示例 2:

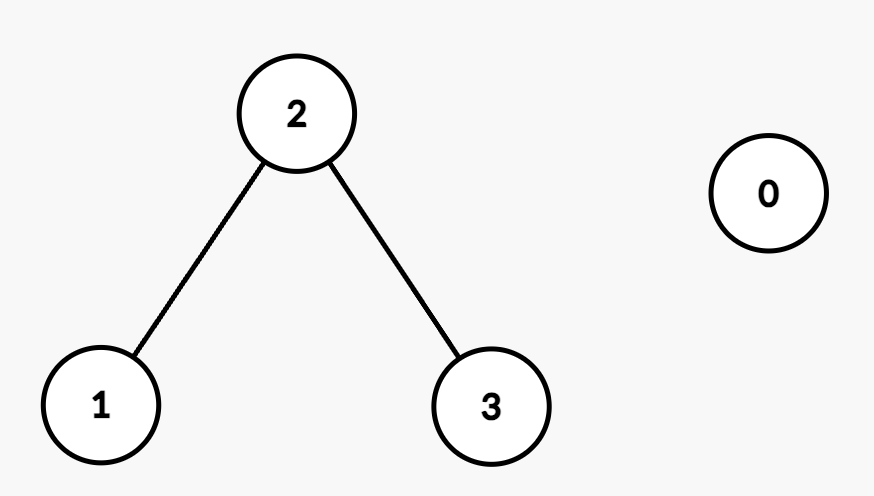
输入: n = 4, nums = [2,5,6,8], maxDiff = 2, queries = [[0,1],[0,2],[1,3],[2,3]]
输出: [false,false,true,true]
解释:
生成的图如下:
查询 [0,1]:节点 0 和节点 1 之间没有边,因为 |nums[0] - nums[1]| = |2 - 5| = 3,大于 maxDiff。
查询 [0,2]:节点 0 和节点 2 之间没有边,因为 |nums[0] - nums[2]| = |2 - 6| = 4,大于 maxDiff。
查询 [1,3]:节点 1 和节点 3 之间存在路径通过节点 2,因为 |nums[1] - nums[2]| = |5 - 6| = 1 和 |nums[2] - nums[3]| = |6 - 8| = 2,都小于等于 maxDiff。
查询 [2,3]:节点 2 和节点 3 之间有一条边,因为 |nums[2] - nums[3]| = |6 - 8| = 2,等于 maxDiff。
因此,在处理完所有查询后,最终答案为 [false, false, true, true]。

说明:

  • 1 <= n == nums.length <= 10^5
  • 0 <= nums[i] <= 10^5
  • nums 按 非递减 顺序排序。
  • 0 <= maxDiff <= 10^5
  • 1 <= queries.length <= 10^5
  • queries[i] == [ui, vi]
  • 0 <= ui, vi < n

思路

有 n 个节点编号为 0 ~ n - 1,节点之间的边由非递减数组 nums 与变量 maxDiff 给出,如果两个节点的差值不超过 maxDiff 则表示它们之间有一条无向边。有一个查询数组 queries,返回每次查询的两个节点是否连通。

由于 nums 非递减,只需考虑相邻节点是否连通即可。如果相邻节点不连通,那么跨过这对节点的区间都不连通。可以使用并查集维护连通性。

代码


/**
 * @date 2026-07-09 8:50
 */
public class PathExistenceQueries3532 {

    class UnionFind {
        private final int[] fa;

        public UnionFind(int n) {
            fa = new int[n];
            Arrays.setAll(fa, i -> i);
        }

        public int find(int i) {
            if (i != fa[i]) {
                fa[i] = find(fa[i]);
            }
            return fa[i];
        }

        public void union(int a, int b) {
            int x = find(a);
            int y = find(b);
            if (x < y) {
                fa[y] = x;
            } else if (x > y) {
                fa[x] = y;
            }
        }
    }

    public boolean[] pathExistenceQueries(int n, int[] nums, int maxDiff, int[][] queries) {
        UnionFind uf = new UnionFind(n);
        for (int i = 1; i < n; i++) {
            if (Math.abs(nums[i] - nums[i - 1]) <= maxDiff) {
                uf.union(i, i - 1);
            }
        }
        boolean[] res = new boolean[queries.length];
        for (int i = 0; i < queries.length; i++) {
            res[i] = uf.find(queries[i][0]) == uf.find(queries[i][1]);
        }
        return res;
    }
}

性能